去重前先问“相同”按什么算
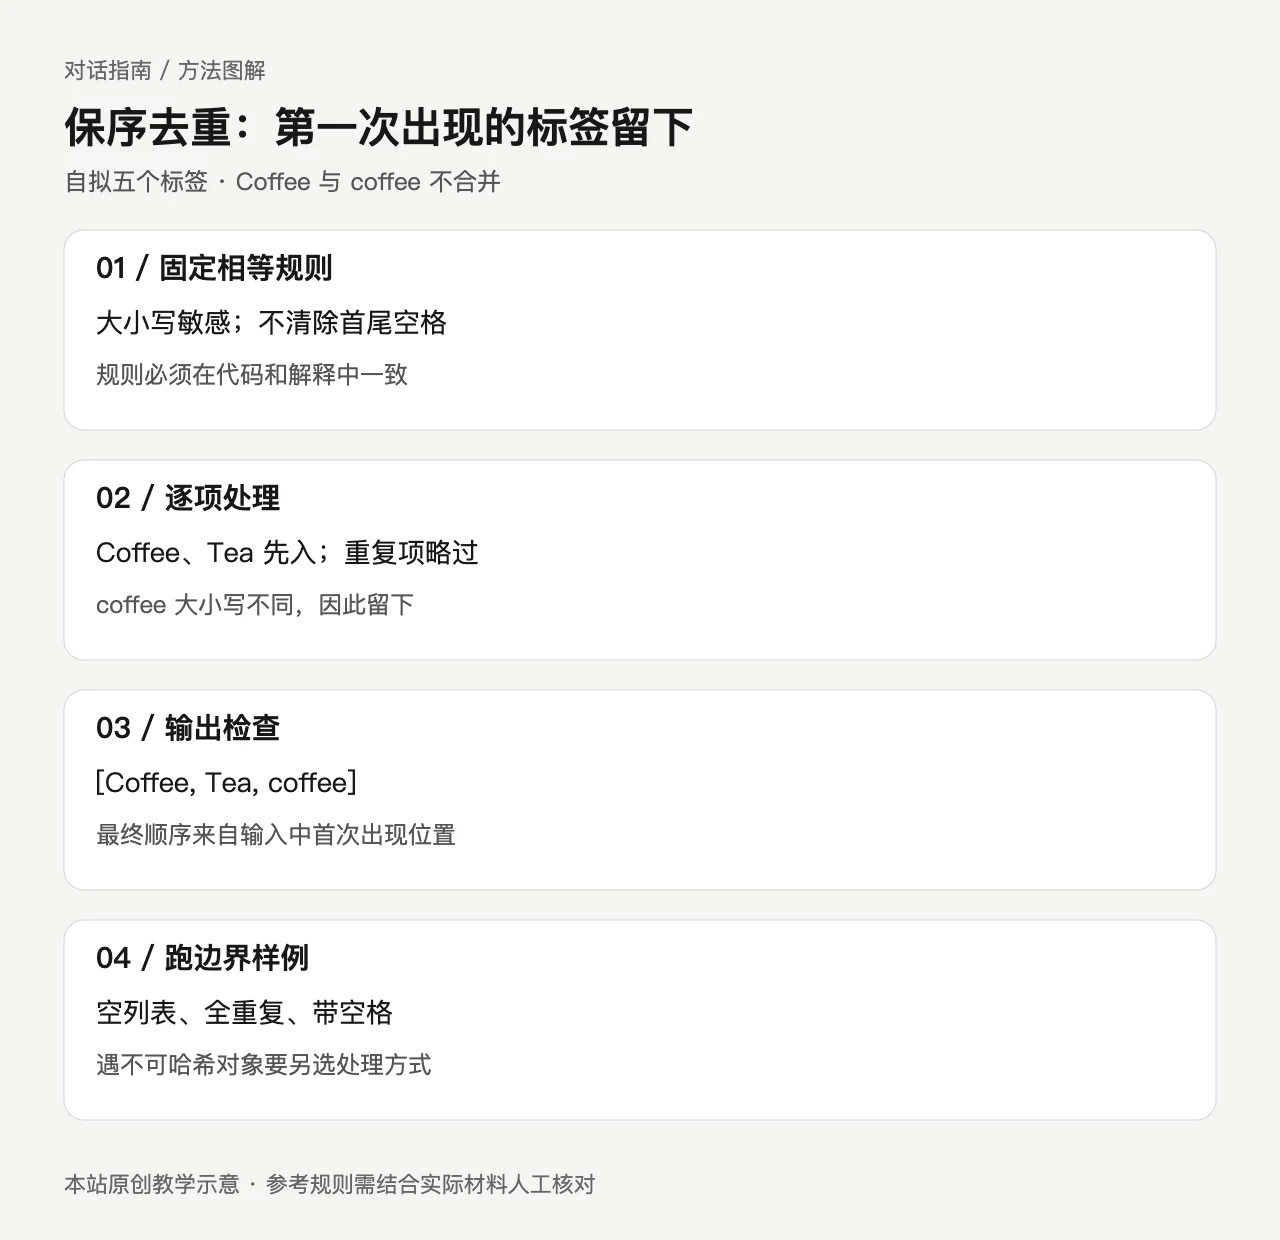
让 ChatGPT 写 Python 列表去重,最容易漏的是规则。下面这组自拟标签为 ["Coffee", "Tea", "Coffee", "coffee", "Tea"]。如果大小写敏感、保留第一次出现的顺序,结果应为 ["Coffee", "Tea", "coffee"];如果忽略大小写,结果就会变成另一组,不能把两者混用。
写一个能由初学者检查的参考实现
本例选择大小写敏感,不去除首尾空格,不改写输入列表。参考代码:
seen = set()
result = []
for item in tags:
if item not in seen:
seen.add(item)
result.append(item)
这里 tags 是上面的输入列表。result只在第一次遇到某个字符串时追加,因此保留首次出现顺序。集合用来检查是否见过,并不直接作为最终展示顺序。示例只处理字符串;面对不可哈希对象时,这段代码不适用。
手工逐项走过五个位置
位置1 Coffee:没见过,追加。位置2 Tea:追加。位置3 Coffee:已见过,略过。位置4 coffee:大小写敏感,和 Coffee 不相同,追加。位置5 Tea:已见过,略过。最终三个元素的次序是首次出现的次序,而不是字母顺序。
若直接写 list(set(tags)),列表内容的显示顺序不应当被当作保序保证。若使用 dict.fromkeys(tags)再转列表,可利用字典保留插入顺序,但仍需讲清当前 Python 环境与相等规则。本文使用显式循环,便于审查和修改。
边界情况用实际输出说话
空列表应得到空列表。全部相同的 ["A","A"] 应只留一个 "A"。带空格的 "Tea" 与 " Tea " 依当前规则不同,不能在解释时暗中 trim。若要忽略大小写而保留第一次原文,可改用规范化键检查,但结果应仍存原始 item,并把合并规则写进需求。
本站用本地 Python 3.9.6 运行参考列表、空列表与重复边界,并核对结果;这里没有调用 ChatGPT 生成或执行代码。复制到真实项目时,先确认输入类型、是否允许空值及大小写政策,尤其不要对用户名称、标识符等字段自行合并。
让模型解释可验证的行为
提示词里给出输入和预期结果,要求模型说明“第一次”按哪种顺序判断、是否会改变原列表、什么输入会失效。随后自己运行最小测试并审查边界。代码能跑只是第一步;保序、规则一致、异常情况符合业务需求,才是可采用的结果。