读入成功不等于字段读对
请 ChatGPT 写“读取 CSV”时,先给它表头、编码、分隔符和空值处理要求。下面使用虚构报名表,只演示 Python 标准库的 csv.DictReader。它按表头生成每行字典,有利于按字段名读取;但如果原表头拼错或重复,仍需要人工检查。代码读到数据并不等于数据已经可信。
从一个最小样例开始
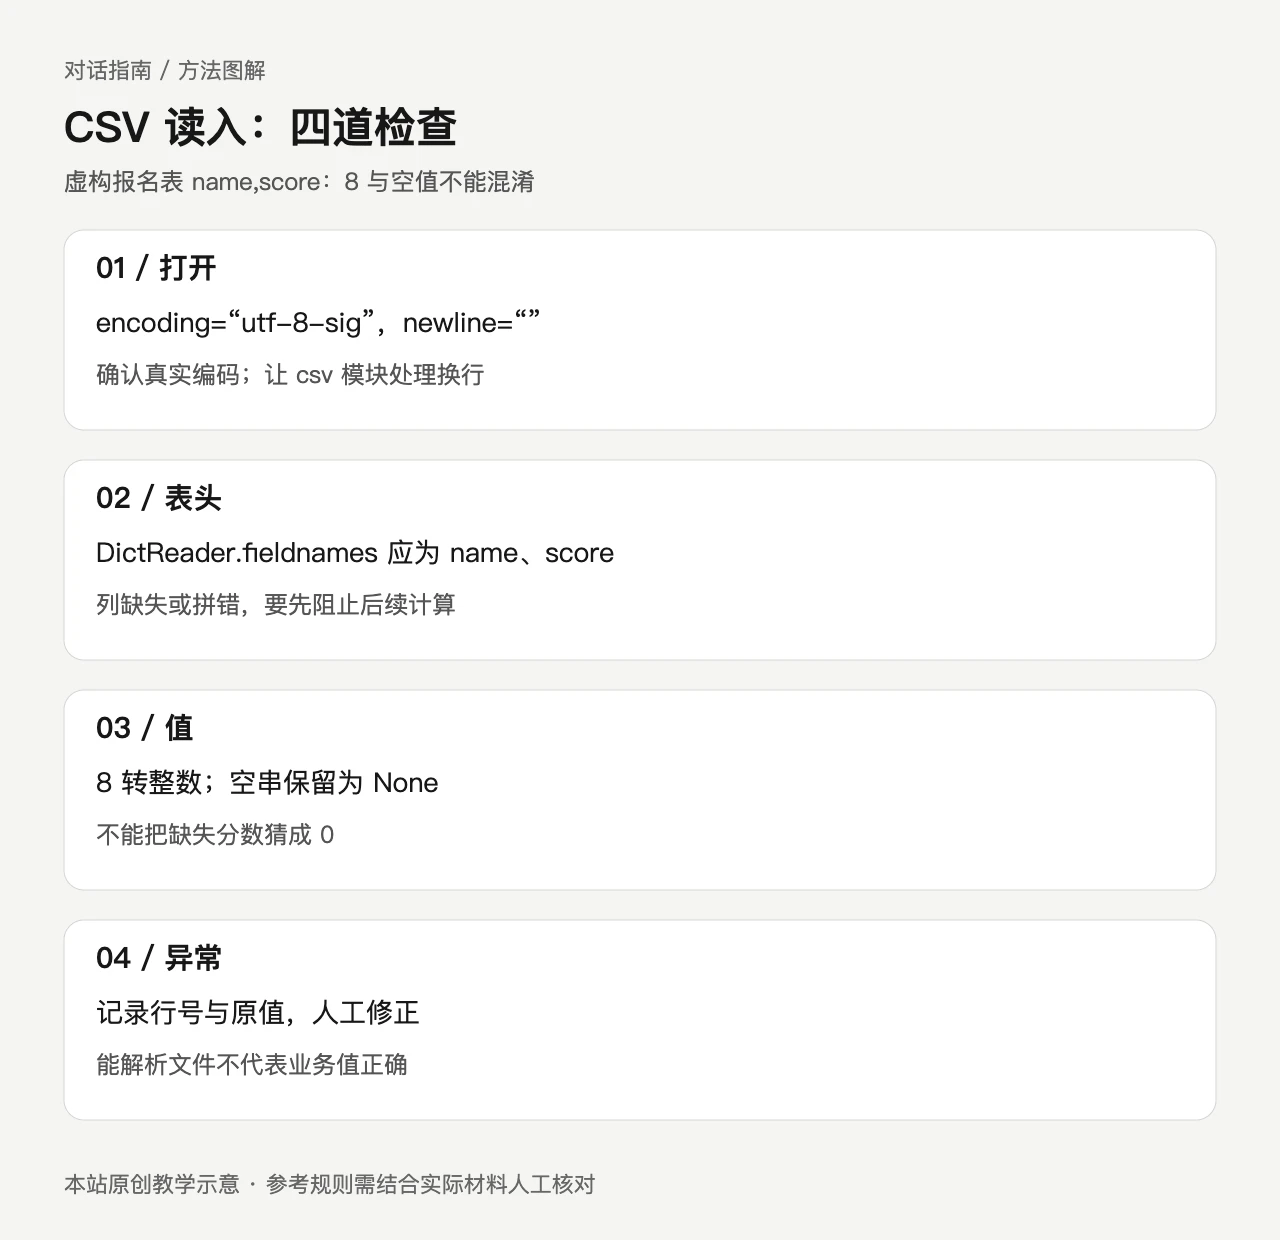
假设文件三行文本为 name,score 换行后是 阿青,8 与 小林,。目标是保留两行,score 空白标记为缺失,不擅自填0。打开文件时可写 with open(path, encoding="utf-8-sig", newline="") as f: reader=csv.DictReader(f);utf-8-sig 兼容开头带 BOM 的 UTF-8 文件,newline="" 则让 csv 模块自行处理换行。若输入不是 UTF-8,应先确认真实编码,而不是在出错时无条件忽略字符。
读取前检查 reader.fieldnames 是否恰为 ['name','score'],再逐行读取。对每行的 score,可先 strip();空串记为 None,非空再尝试 int()。这样阿青的分数是整数8,小林仍为缺失。若“8分”这种文字混入,int() 会失败,应记录该行错误,不能静默变为8,除非输入规范明确允许。
提示词要包含失败策略
要求模型处理三种异常:缺少 score 列、分数为空、分数不可解析。第一种是文件格式错误,应停止或退回;第二种保留缺失;第三种标明行号供人工修正。让模型同时给出最小测试输入与预期结果,才能判断它是否误把空值变为0。
上线前核对源文件
本站在本地 Python 环境用上述虚构三行样本核对了表头、8和空值;这并非用户文件的读取结果。真实文件可能使用分号分隔、含引号里的逗号或另有编码。先抽查原始行与读入后的字段,保存副本;涉及姓名等个人信息时不要把整份生产数据直接贴进对话。若你需要的是**生成** CSV,可看本站 [CSV 输出教程](/articles/chatgpt-csv-output),输入和输出属于不同任务。