先定义程序真正需要的结构
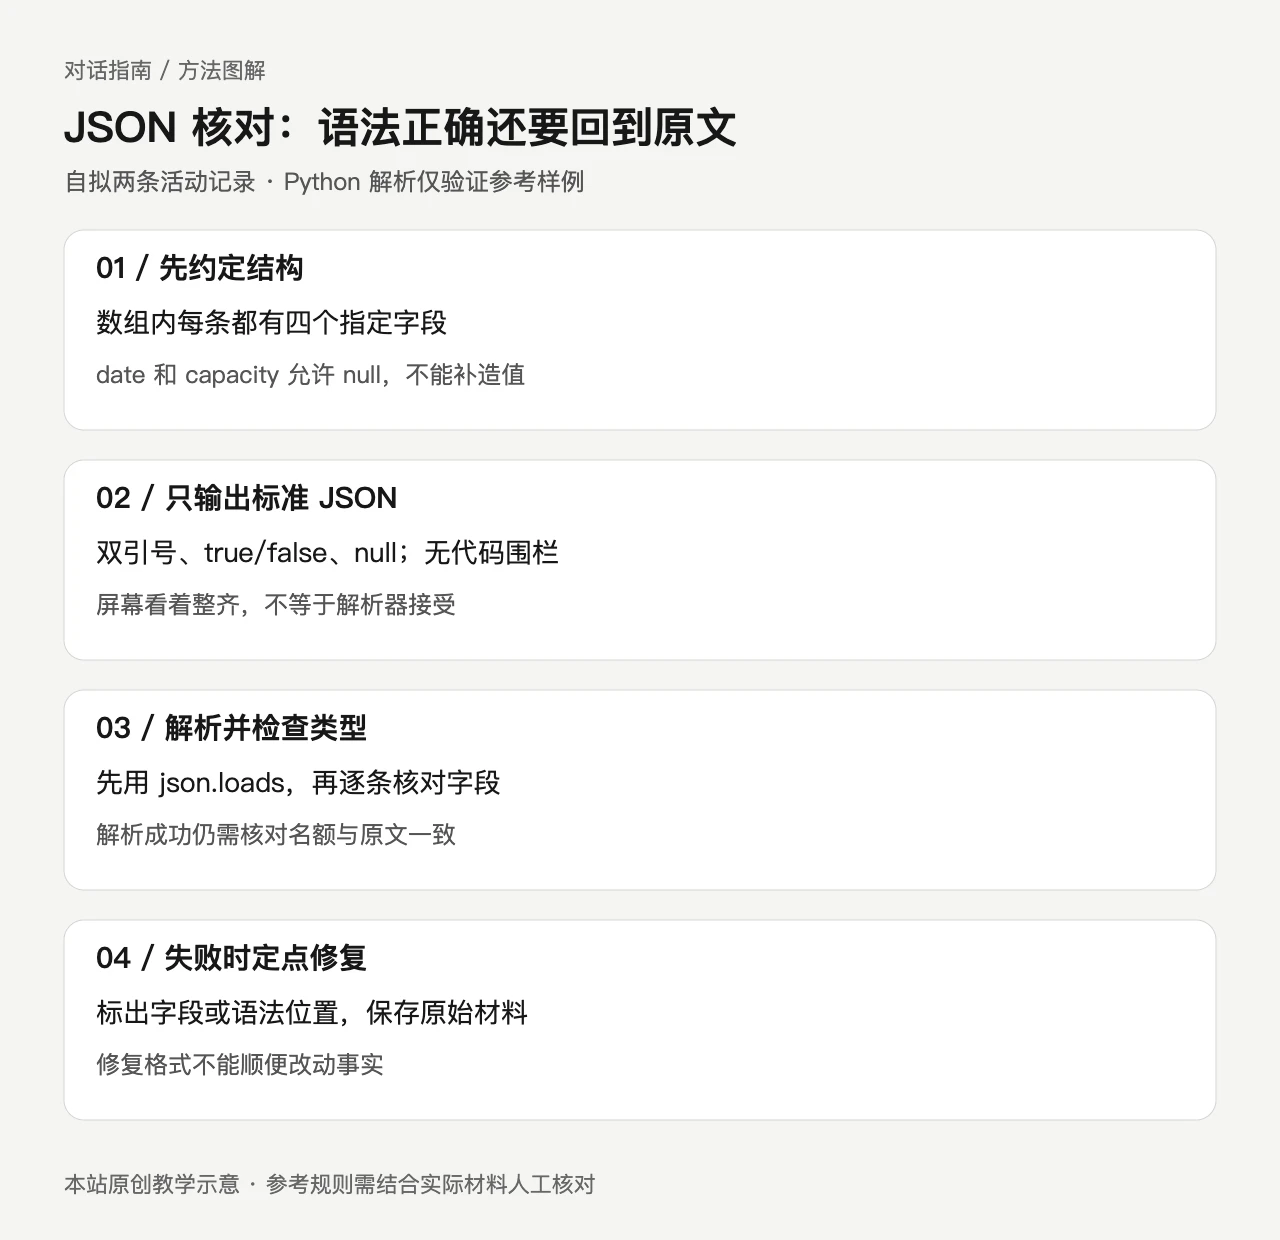
让 ChatGPT 输出 JSON 时,不要只说“给我 JSON 格式”。先约定顶层是数组还是对象、每条记录有哪些字段、字段的类型和缺失值如何表示。本文自拟两条活动记录,只演示结构审查;展示的 JSON 是编辑编写并用 Python 解析的参考例子,未声称模型实际输出了这些字节。
用两条足够小的记录说明字段
原始材料是:“活动A,2026-10-20,20个名额,报名开放”;“活动B,日期待定,名额未确定,报名未开放”。目标字段依次是 code、date、capacity、registration_open。code 与 date 是字符串;capacity 是整数或 null;registration_open 是布尔值。日期未确定时 date 用 null 而不是一个编造日期,所以还需明确 date 也允许 null。
参考结果:[{"code":"A","date":"2026-10-20","capacity":20,"registration_open":true},{"code":"B","date":null,"capacity":null,"registration_open":false}]。这里 false 只对应材料中的“未开放”,不能将“没有提到是否开放”也推成 false。输入材料若没说明,应另设 unknown 规则,而不是暗中填值。
提示词要求输出本身可解析
要求“只输出 JSON 数组,不加 Markdown 围栏、开场白和解释”;指定 UTF-8 文本,键名完全照约定,不补活动地点、价格或报名链接。常见错误包括单引号包字符串、在最后一项后多写逗号、布尔值写成 True/False,以及把 null 写成中文“未知”。这些在屏幕上像数据,标准 JSON 解析器却可能拒绝。
说明字段顺序有助于人阅读,但消费者应依键名读取,不能依赖对象键在视觉上的排列。更关键的是数组内每条记录都具有相同字段与预期类型。
用解析和类型检查做第二道门
可以用 Python 的 json.loads(text)先检查语法,再逐条检查键集合、类型与允许的空值。解析成功不等于语义正确:如果把活动B的capacity写成20,语法仍然完全合法。核对时必须回到原始材料,逐行比对,不把能解析当作真实可信。
本例在本地 Python 3.9.6 中解析了上面的参考字符串并断言两条记录的字段和类型;它是代码核对,不是 ChatGPT 的运行截图。若程序需要额外字段,应先修改约定和样例,再生成一次,避免应用端悄悄容忍缺字段。
处理失败时保留原始输入
若解析失败,记录出错位置,让模型只修复语法,不请它重新“补全信息”;若类型不符,指出具体记录与字段。保存原始材料和候选结果,人工核对修复前后是否改动了日期或名额。批量处理含敏感信息前,还需按工作场景确认是否可以传给第三方工具。
这个方法适合程序要读入的结构化结果。若只是给同事阅读,普通表格可能更直接;不要为了显得专业而强制把每次沟通变成 JSON。