先区分“筛订单”与“筛用户”
让 ChatGPT 写统计 SQL,最常见的含糊处是“只看金额大于100的用户”:到底是只统计每笔超过100的订单,还是统计**总金额**超过100的用户?前者作用于原始行,通常放 WHERE;后者作用于分组汇总,通常放 HAVING。条件没有说清时,模型给出可运行语句也可能回答错问题。以下是自拟订单,已在本地 SQLite 运行验证。
五笔订单,先手算两种结果
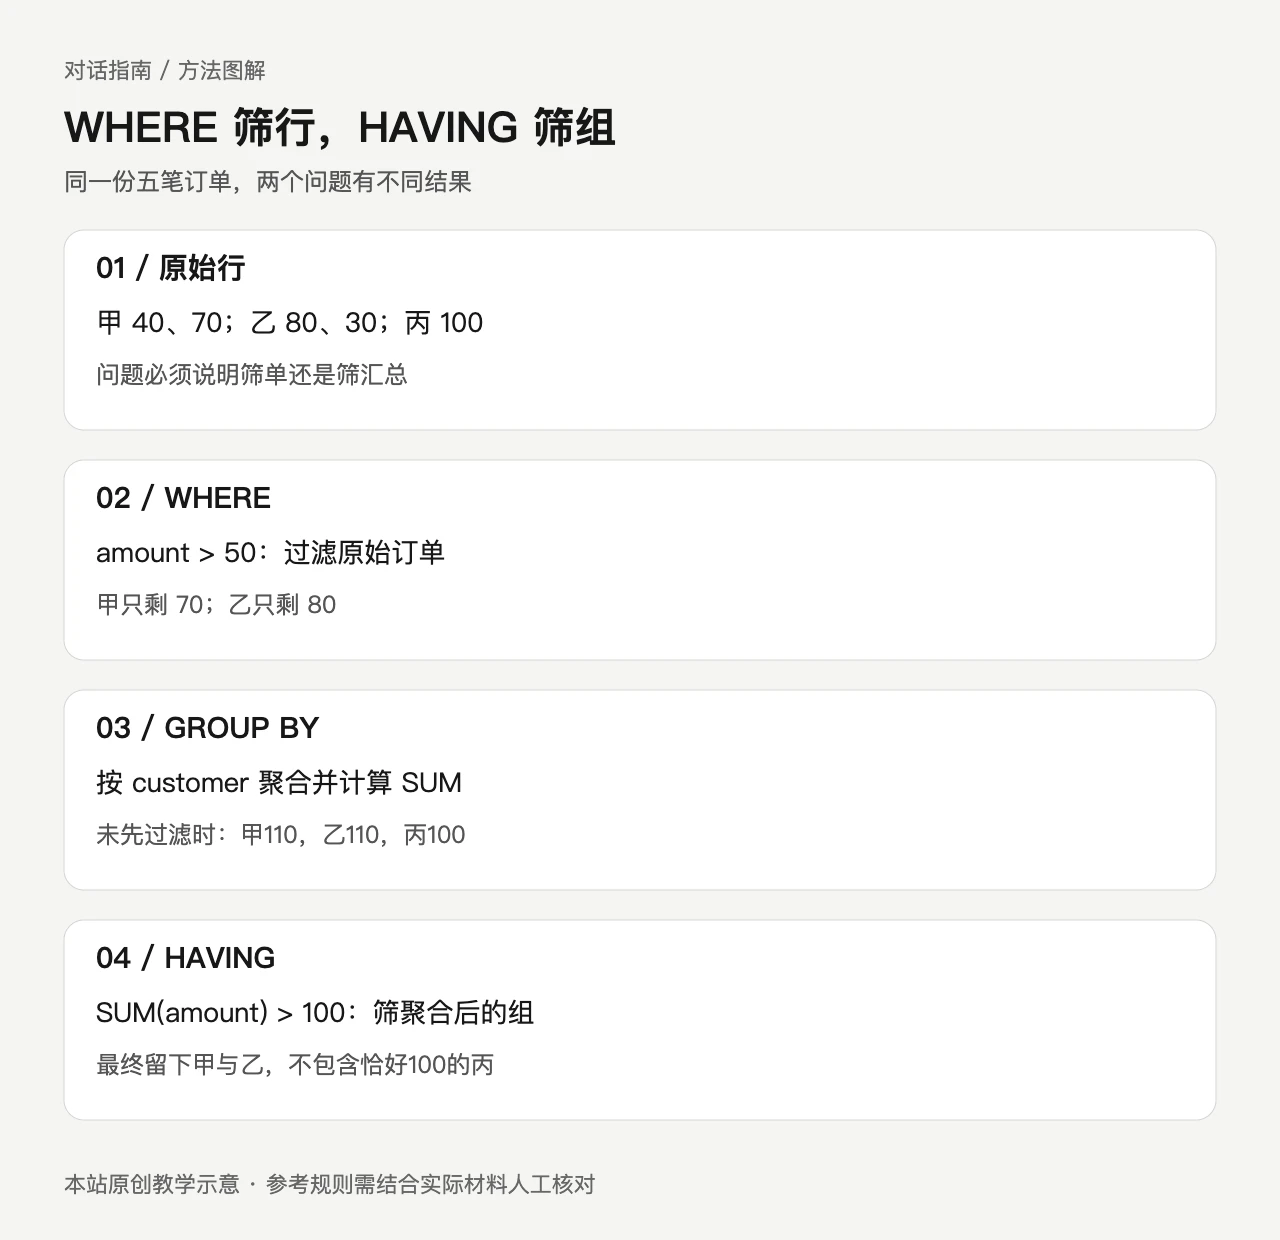
orders 表有 customer 和 amount 两列:甲40、甲70、乙80、乙30、丙100。若问题是“各用户总金额超过100”,先 GROUP BY customer,再 HAVING SUM(amount)>100。甲是110、乙是110,丙恰好100不满足大于,因此只返回甲和乙。参考语句:SELECT customer, SUM(amount) AS total FROM orders GROUP BY customer HAVING SUM(amount)>100 ORDER BY customer。
若改问“先排除金额不超过50的单,再按用户合计”,WHERE amount>50 应放在 GROUP BY 之前;这时甲只剩70,乙剩80,丙100。两种查询的业务意义不同,不能把 HAVING 机械替换成 WHERE。
给模型完整的统计口径
输入表结构、阈值是 > 还是 >=、是否包含退款或 NULL、结果希望按谁排序。让它同时给出一个五行小样本与手算结果,再给 SQL。这里讨论的是单表汇总,不处理没有订单的用户;若必须保留零订单用户,请看本站 [LEFT JOIN 零订单计数教程](/articles/chatgpt-sql-left-join-count)。
运行时的复查路径
先执行原始明细查询,确认每一笔应计入的订单;再看 GROUP BY 中每组的 SUM;最后加 HAVING。逐步加条件比一次粘贴长 SQL 容易发现口径变形。本站的核对使用自拟样本和 SQLite;其他数据库的语法、NULL 与类型行为要以目标系统实际运行和官方文档为准。不要把包含真实顾客信息的明细直接提交给外部对话工具。